
Regresión Lineal y Regresión Logística son algoritmos clásicos de Aprendizaje Automático. Es un error pensar que estos dos algoritmos son idénticos y se pueden aplicar a las mismas tareas a pesar de sus nombres similares.
En este artículo, entenderá qué son la regresión lineal y logística, sus principales diferencias y aplicaciones.
Los conceptos básicos del Aprendizaje Automático
ML es un subcampo de la Inteligencia Artificial que permite a los algoritmos aprender de ejemplos (datos) y generar un modelo matemático/estadístico sin ser programados explícitamente por un ser humano. Esta característica conduce a la expresión (Domingos, 2017) "Machine Learning es una tecnología que se construye a sí misma".
Los algoritmos de Aprendizaje Automático se pueden utilizar para predicciones, clasificaciones, segmentaciones y reducción de dimensionalidad de forma automática sin intervención humana.
Hay numerosos algoritmos, cada uno con sus fortalezas y debilidades. La Regresión Lineal y la Regresión Logística son ejemplos de tales algoritmos y a pesar de sus nombres similares no son lo mismo.
Programación Tradicional vs. Aprendizaje Automático
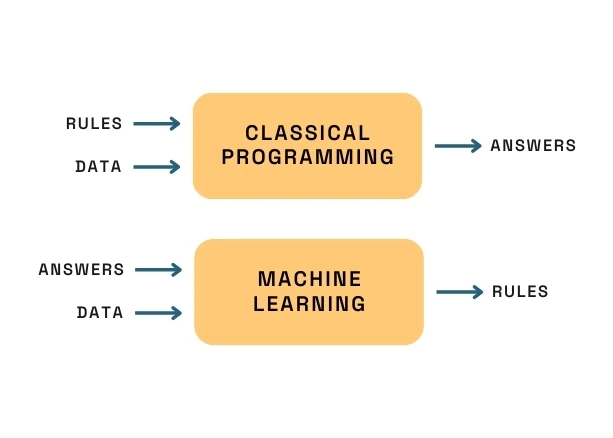
- En la programación tradicional el desarrollo de software requiere una programación explícita de un conjunto de reglas definidas para lograr la salida deseada y es realizado por un ser humano (programador).
- Los algoritmos de ML, por otro lado, aprenden automáticamente a partir de los datos y generan reglas o modelos en función de este aprendizaje.
Tipos de Aprendizaje Automático
Antes de explicar los algoritmos de Regresión Lineal y Regresión Logística es necesario entender los tipos de ML y sus tareas y aplicaciones respectivas.
Están definidos en función de su aplicación, complejidad y el tipo de datos que pueden aprender, entre otras características. La literatura técnica divide típicamente el Aprendizaje Automático en tres tipos de aprendizaje como se describe a continuación:
- Aprendizaje Supervisado
- Aprendizaje No Supervisado
- Aprendizaje por Refuerzo
Aprendizaje Supervisado
En este tipo, los algoritmos se entrenan utilizando datos etiquetados, lo que significa que el algoritmo conoce la salida correcta para una variable de entrada determinada en el conjunto de entrenamiento. Este tipo de aprendizaje se puede aplicar a tareas de regresión y clasificación.
Regresión estudia las relaciones entre variables numéricas continuas y se utiliza en diversas aplicaciones de predicción como la predicción del precio de un coche y la estimación de ventas. La Regresión Lineal es uno de los algoritmos de regresión más populares.
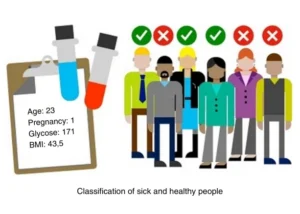
Clasificación tiene como objetivo indicar a qué clase pertenece un objeto o dato y se puede utilizar para clasificar si un paciente tiene una enfermedad determinada o no, la retención de clientes (tasa de abandono), etc. La Regresión Logística es un ejemplo de algoritmo que se puede aplicar a la clasificación.
Aprendizaje No Supervisado
En este, los algoritmos se entrenan utilizando datos no etiquetados, lo que significa que no hay respuestas previamente conocidas en las que basar el análisis. El modelo debe descubrir patrones por sí mismo.
Una de las ventajas significativas del aprendizaje no supervisado es precisamente el descubrimiento de patrones desconocidos y la síntesis de un gran volumen de datos. Este tipo de aprendizaje se puede aplicar a tareas de clustering, asociación y resumen.
Aprendizaje por Refuerzo
Se basa en la retroalimentación de interacciones anteriores. Este tipo de aprendizaje mejora continuamente su modelo. Utiliza el concepto de recompensa y castigo. Se da una recompensa por una acción correcta y un castigo por una incorrecta. Se utiliza ampliamente en modelos que aprenden de juegos (Backgammon, Chess, Go) y navegación de robots.
Algunas literaturas también mencionan un cuarto tipo de aprendizaje que es el aprendizaje semisupervisado, que se refiere al uso de datos etiquetados y no etiquetados.
Regresión Lineal
La Regresión Lineal se considera uno de los algoritmos de Machine Learning más simples y ampliamente utilizados. Un ejemplo clásico de Regresión Lineal es la predicción de precios de coches.
El algoritmo de Regresión Lineal modela la relación entre una variable dependiente y (precios de coches) y una o más variables independientes x (tamaño, número de puertas, potencia del motor, emisión de CO2, etc.). Luego, el algoritmo utiliza este modelo para hacer predicciones sobre nuevos datos.
La Regresión Lineal es popular porque es simple de entender e implementar. También es eficiente computacionalmente y escalable. Sin embargo, este algoritmo puede fallar con conjuntos de datos más complejos.
Regresión Logística
La Regresión Logística es un tipo de modelo estadístico utilizado para tareas de clasificación. El algoritmo de Regresión Logística modela la relación entre una variable dependiente y (la etiqueta) y una o más variables independientes x (las características).
Luego, el algoritmo utiliza este modelo para hacer clasificaciones sobre nuevos puntos de datos. Las clasificaciones realizadas por el algoritmo de Regresión Logística son probabilidades de que un punto de datos pertenezca a una clase específica. “Logística” se refiere a la función Logit que se utiliza para mapear probabilidades entre 0 y 1.
Regresión Lineal vs. Regresión Logística
Aquí hay un resumen de las principales diferencias y aplicaciones de los algoritmos de Regresión Lineal y Regresión Logística:

Aunque la Regresión Lineal y la Regresión Logística comparten una nomenclatura y principios fundamentales similares en Machine Learning, sirven para propósitos distintos y se aplican a diferentes tipos de problemas.
En Loxias aprovechamos estos algoritmos para desarrollar soluciones que generan eficiencia y perspicacias para empresas de diversas industrias. ¡Aprende más aquí!